كرتين MI50 (الجزء الثالث): DeepSeek-V4.1-Flash بحجم 552 مليار بارامتر على كرتين من 2018
وين وقفنا
في الجزء الثاني وصلت Qwen3.8-27B لـ 74 توكن بالثانية وكونتكست 200 ألف توكن على كرتين AMD MI50 بـ 16 جيجا. هالجزء عن موديل أكبر بكثير: DeepSeek-V4.1-Flash-1017، حجمه 552 مليار بارامتر، على نفس الكرتين اللي من 2018.
الرقم مو غلط. الموديل mixture of experts: فيه 40 طبقة، كل طبقة فيها 384 expert، وكل توكن يستخدم 6 بس منهم في كل طبقة. وجنبه جدول n-gram اسمه Engram حجمه حوالي 200 مليار بارامتر، الموديل يقرأ منه كم صف لكل توكن. وحتى لو ضغطت الأوزان لأقل من 2 بت، الـ experts لحالهم حوالي 115 جيجا. وكروتي مع بعض 32 جيجا.
أول محاولة كانت بمحرك Xolotl (fork من Strata) ووصلت 7 توكن بالثانية. هالأسبوع صار شيئين: Strata نزّلوا محرك خاص لـ DeepSeek منقول من Project Maya، و Maya نفسه تطوّر أكثر. فنقلت الاثنين لكروت MI50 وقست الثلاثة.
الخلاصة بسرعة
| قبل (Xolotl) | الحين (Project Maya بعد النقل لـ gfx906) | |
|---|---|---|
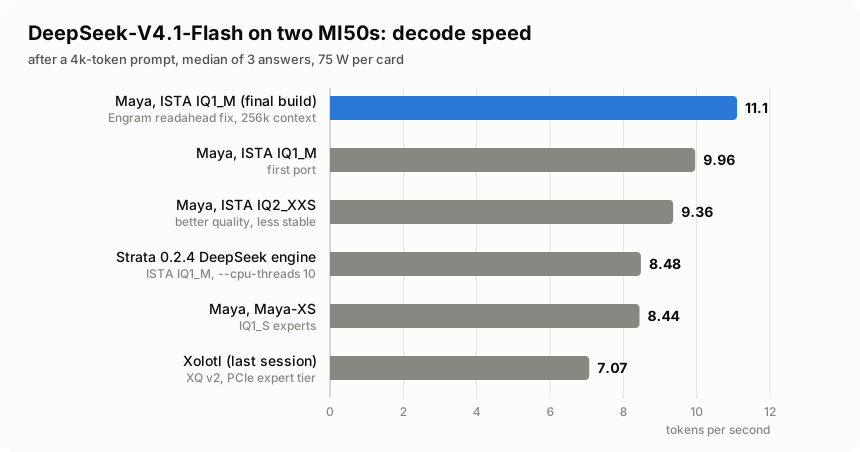
| التوليد بعد برومبت 4 آلاف توكن | 7.07 توكن/ث | 9.96 إلى 11.10 توكن/ث |
| قراءة البرومبت (4 آلاف توكن) | 36 توكن/ث | 69 إلى 72 توكن/ث |
| الـ system prompt حق opencode (7.4 ألف توكن) | — | ينقرأ بـ 89 توكن/ث، وبعدها يتعاد استخدامه بين الأدوار |
| مهام الـ agent (opencode على 5 ريبوهات) | تشغيل واحد، 637 ثانية | 5 من 5 نجحت، كل مهمة 205 إلى 591 ثانية |
| التعليق وقت التوليد في مهام الـ agent | — | لين 50 ثانية ← راح في المهام القصيرة، وباقي 10 إلى 20 ثانية مع الكونتكست الطويل |
| الكونتكست | 64 ألف | 256 ألف (الـ KV cache المضغوط 0.25 جيجا بس) |
الكرتين مقيّدين على 75 واط لكل كرت، وتبريدهم passive، وكل تشغيل تحت مراقبة حرارة.
الجهاز
- كرتين AMD MI50 / Radeon Pro VII بـ 16 جيجا (gfx906)، كل كرت على PCIe 3.0 x16، وبدون peer-to-peer
- 12 كور من معالج Xeon E5-2680 v4 (من 2016، فيه AVX2)، و 62.5 جيجا رام، و NVMe بـ 2 تيرا
- ROCm 7.14 (نسخة mixa3607 لـ gfx906)، وكل شي داخل Docker في LXC على Proxmox
الكروت تشيل حوالي 16% بس من الـ experts. الباقي لازم يجي من الرام أو الـ SSD مع كل توكن، وهذا الشي يحدد كل اللي بعده.
ثلاث محركات
Xolotl (اللي نقلته المرة اللي فاتت) يحط أكثر الـ experts استخدام على الكروت، والباقي ينسخه عبر PCIe من رام محجوزة. على PCIe 3.0 هالنسخ هو السقف: حوالي 570 ميجا لكل توكن. وأحدث نسخة من Xolotl طلعت أبطأ على gfx906 (5.96 بدل 7.07) لأنها تتخطى خطوة prefetch تفيد على هالجهاز.
Strata 0.2.4 نزّل strata-dsv41، محرك منفصل لـ DeepSeek منقول من Project Maya. نسخة AMD منه تستهدف كروت RDNA بس
(wave32)، وملف CMake يستثنيه صراحة من بناء gfx906.
Project Maya (maya-ds4) هو الأصل. يدعم أصلًا كرت wave64 واحد، الـ MI100 (gfx908): أربعة منها شغّلت DeepSeek بـ 52
توكن بالثانية، ومعاها 128 جيجا VRAM. فيه pull request مفتوح يضيف MI50 لمحرك GLM حق Maya، ومكتوب فيه بوضوح إن DeepSeek ما
انجرب. وعلى حد علمي، محد شغّل محرك DeepSeek حق Maya على gfx906 قبل.
بدل ما يحمّلون الـ experts للكرت، Maya و Strata يحسبون الـ experts اللي ما تدخل الـ VRAM على المعالج (اسمها “CPU lane”)، ويقرونها من مكانها في ملفات الموديل: من الرام عن طريق الـ page cache، أو من الـ SSD.
النقل لـ gfx906: مشكلة الـ 64 lane
المحركات هذي مكتوبة بأسلوب CUDA: الـ warp فيه 32 thread. بس gfx906 يشتغل بـ wavefront فيه 64 lane. دعم Maya لـ MI100 يحل هالشي بطبقة توافق تحط كل warp من CUDA على نص wavefront:
- الـ shuffles تشتغل بعرض 32، فالـ lanes من 32 لـ 63 تصير warp منطقي لحالها؛
__ballotيرجّع 64 بت، فكل نص يزحزح الـ 32 بت حقته لمكانها؛__syncwarpيصير fences على مستوى الـ wavefront حول wave barrier؛- الـ builtins حق HIP للـ warp-sync تنطفي، لأنها بتغطي الـ 64 lane كلها؛
- ذاكرة الهوست المربوطة تنحجز coherent، لأن الكرت والمعالج يستنون إشارات بعض.
لـ MI50 كان المطلوب إني أسجّل gfx906 كـ wave64، وأربط __dp4a حق CUDA بتعليمة v_dot4_i32_i8 الموجودة في الكرت. وبعدها
اختبارات الكيرنلات حقت Maya نجحت على MI50: كيرنلات الـ matrix ضمن 1e-7 من مرجع double، وحسابات الـ experts لـ IQ1_S و
IQ1_M و IQ2_XXS وضغط الـ KV cache والـ router طلعت مطابقة بت ببت. الاستثناء الوحيد مسار IQ4_XS/Q4_K نتيجته صحيحة بس
مو مطابقة بت ببت بين طريقتين، وولا موديل هنا يستخدمه.
ولـ Strata نقلت نفس الطبقة لكوده: 62 سطر في 4 ملفات، كلها ورا خيار يشتغل بس مع wave64.
تجهيز الموديل
استخدمت نسخ GSQ-RCO حقت ISTA-DASLab: IQ1_M (121 جيجا، أغلب الـ experts فيه IQ1_S والأوزان الثانية Q5_K) و IQ2_XXS
(138 جيجا)، وجدول Engram حقهم بصيغة IQ4_NL (111 جيجا)، و Maya-XS حق Maya للمقارنة. كان ناقص شيئين: ملفات ISTA ما
فيها إعدادات الـ hash حق الـ Engram ولا أبعاد الـ drafter حق DSpark، فأداة الـ pack حقت Maya ما قدرت تستخدمها. ضفت لها
خيار --engram-meta (زي اللي في Strata) ياخذ هالقيم من ملف metadata صغير (5.8 ميجا) من Unsloth. ولـ Maya-XS ضفت
--partial-split يستخدم ملفات الموديل حقته مع جدول Engram حق ISTA، ووفرت تحميل 161 جيجا. وكل ملف انفحص بـ SHA-256.
وبعدها Maya يوزّع الموديل كذا:
- الكرت الأول: الطبقات 0 لـ 19، الكرت الثاني: الطبقات 20 لـ 39 مع الـ output head. الـ tensor parallel ما يقدر يقسم البلوكات (256 قيمة) بالتساوي، فيرجع لتقسيم بالطبقات. كل كرت فيه حوالي 3 جيجا أوزان dense وحوالي 1,300 expert.
- الـ CPU lane: الباقي، حوالي 12,800 expert (95 جيجا)، على 10 threads (اختيار Maya نفسه، و 12 كانت أبطأ).
- Maya يقيس بعد هل نقل الـ experts للكرت عبر PCIe أسرع من المعالج. على هالجهاز لا، فطفّاه من نفسه.
النتايج
كل تجربة تبدأ بعد ما أطلّع ملفات الموديل من الـ page cache، وبعدها warm-up بـ 256 توكن، وبعدها 3 إجابات كل وحدة 128 توكن لكل برومبت. الأرقام median بالتوكن/ث:
| المحرك والموديل | نص 4 آلاف | كتابة كود | تعديل كود | قراءة البرومبت (4 آلاف / 271 / 1,384 توكن) |
|---|---|---|---|---|
| Maya، ISTA IQ1_M (النسخة النهائية) | 11.10 | 7.77 | 8.23 | 68.9 / 17.1 / 46.2 |
| Maya، ISTA IQ1_M (أول نقل) | 9.96 | 9.97 | 9.24 | 71.9 / 14.9 / 46.2 |
| Strata 0.2.4، ISTA IQ1_M | 8.48 | 9.18 | 10.13 | 40.4 / 8.8 / 9.4 |
| Maya، Maya-XS | 8.44 | 9.53 | 9.48 | 58.4 / 17.4 / 4.5 |
| Maya، ISTA IQ2_XXS (النسخة النهائية) | 9.36 | 6.26 | 7.15 | 48.8 / 14.0 / 2.7 |
| Xolotl، XQ v2 (المرة اللي فاتت، بدون warm-up) | 7.07 | — | — | 36 / — / — |
في التوليد Maya و Strata تقريبًا متعادلين. اللي يحسم هو قراءة البرومبت: Maya يقرأ أسرع بـ 1.7 إلى 5 مرات، والـ agents
يقرون أكثر بكثير من اللي يكتبونه. وفيه مفاجأة من Strata: حسب عدد كورات الـ CPU من الهوست مو من الكونتينر، وشغّل 28
thread على 12 كور، والسرعة كانت 1.8 توكن/ث لين ما حطيت --cpu-threads 10.
الجودة. قست الـ perplexity على نص ثابت 3,000 توكن كتبته بنفسي (كود ونص الموديل ما شافه قبل). هذي مقارنة نسبية، مو benchmark:
| الموديل | Perplexity |
|---|---|
| Xolotl XQ v2، توجيه طبيعي (exact routing) | 5.21 |
| Xolotl XQ v2، توجيه يميل للـ cache بقيمة 0.5/0.3 (الافتراضي عنده) | 5.60 |
| Xolotl XQ v2، توجيه 1.0/0.6 (8.97 توكن/ث) | 7.89 |
| Maya، ISTA IQ1_M | 5.61 |
| Maya، Maya-XS | 5.47 |
| Maya، ISTA IQ2_XXS | 5.35 |
لما زودت ميل Xolotl للـ cache وصلت 8.97 توكن/ث (أسرع بـ 27% من إعداده الافتراضي)، بس الـ perplexity زادت 41% (و 51% مقارنة بالتوجيه الطبيعي)، فتركتها. و ISTA IQ1_M على Maya بنفس جودة الإعداد الافتراضي حق Xolotl وهو الأسرع، فصار هو الافتراضي عندي. IQ2_XXS أحسن جودة بس أبطأ وأقل ثبات هنا: 132 جيجا experts كثير على 62 جيجا رام.
وين يروح الوقت
Maya يقدر يقيس كل مرحلة من التوكن على الكرت (DS4_PROF=1):
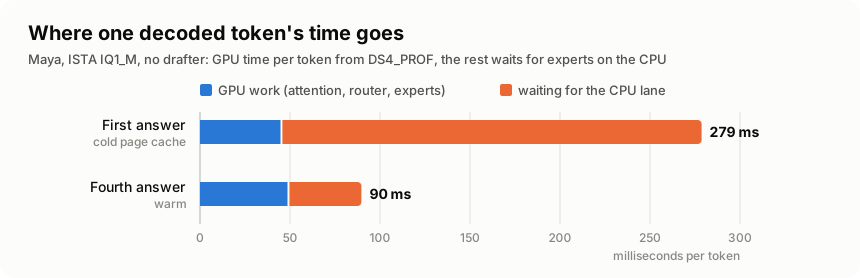
| لكل توكن | بارد | حار |
|---|---|---|
| الـ attention | 26.5 ms | 28.1 ms |
| الـ router والـ shared expert | 10.7 ms | 11.3 ms |
| الـ experts على الكرت | 7.9 ms | 9.6 ms |
| انتظار الـ CPU lane | 233.4 ms | 40.5 ms |
شغل الكرت حوالي 49 ms لكل توكن، والباقي انتظار للـ experts على المعالج. ولما يكون الـ page cache بارد، الانتظار يكون للديسك.
التعليق، وتصليح من 10 أسطر
في أول تجارب الـ agent، التوليد أحيانًا كان يعلّق 10 إلى 50 ثانية في نص الإجابة، وبعدها يكمل بسرعته العادية. والمحرك ما يكتب شي في اللوق وقت التعليق. اللي لقيته:
- مؤشر الضغط في Linux (PSI) طلّع إن 12 إلى 20% من الوقت كل المهام واقفة تستنى I/O.
- الـ page cache كان مليان عند حد الكونتينر 62.5 جيجا.
- وقت التعليق، threads المحرك كانت في
folio_wait_bit_commonتستنى صفحات من ملفات الـ experts المربوطة بالذاكرة. - اختبار قراءة مباشرة (direct I/O) من الـ SSD ما شاف ولا قراءة أبطأ من 17 ms، يعني الديسك سليم.
السبب كان جدول الـ Engram. كل بحث يقرأ صف واحد حجمه 144 بايت من مكان عشوائي: 48 صف لكل توكن، ومئات الآلاف لبرومبت طويل. و Maya يسوي هالشي بقراءات buffered عادية، فكل بحث يجيب صفحات كاملة ومعاها readahead حولها للـ page cache. هالزبالة تطلّع الـ experts حق الـ CPU lane من رام هي أصلًا مليانة. و Maya أصلًا يقرأ الـ Engram بدون buffer على Windows، بس مو على Linux.
التصليح إني أعلّم الكيرنل إن هالقراءات عشوائية: posix_fadvise(POSIX_FADV_RANDOM) على ملفات قارئ الـ Engram، و
DS4_EG_RANDOM=0 يرجّع الوضع القديم.
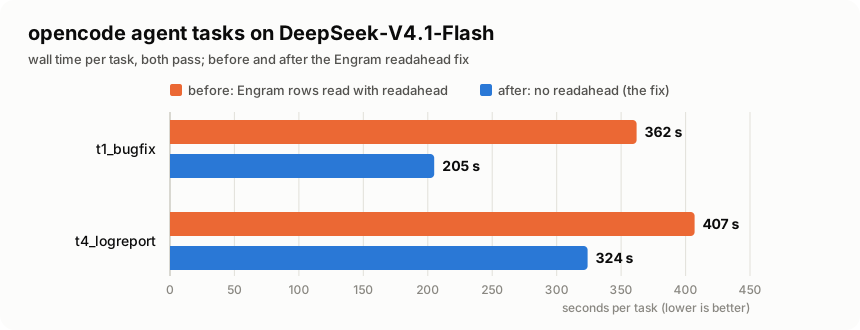
المهمتين اللي أعدتهم صاروا أسرع بـ 20 إلى 43% وبدون ولا تعليق 8 ثواني أو أكثر، مع إن البداية كانت أبرد. بس مو علاج كامل: مهمة الكونتكست الطويل كان فيها تعليقات حوالي 10 إلى 20 ثانية، والـ benchmark البارد اللي يبدّل البرومبتات ممكن يطلع فيه طلب بطيء كل فترة. تعليقات الـ 50 ثانية راحت.
طيب و MTP أو DFlash2؟
DeepSeek-V4.1 يجي معاه drafter خاص فيه اسمه DSpark: ثلاث بلوكات MTP ترسم بلوك لين 5 توكنات مرة وحدة، تبدأ من توكن
noise. هي نفس فكرة DFlash، وملف GGUF حق Unsloth له حتى مكتوب فيه architecture dflash. ما فيه drafter DFlash2 منفصل
لـ V4.1. الـ DFlash drafters اللي في Hugging Face لـ V4-Flash القديم، وأغلبها بصيغة speculators حقت vLLM.
قست DSpark على المحركين:
- Xolotl يستخدمه: 2.10 توكن لكل pass، وهي داخلة في الـ 7.07 توكن/ث.
- Maya مع DSpark بـ 2 بت (4.25 جيجا): انقبل 79 إلى 92% من أول draft، وحوالي 2.2 توكن لكل pass، بس التوليد ما صار أسرع (8.81 مقابل 10.10 توكن/ث في نفس اختبار البرومبت المكرر).
السبب إن الجهاز محدود بالمعالج. التحقق من توكنين أو ثلاثة يلمس كل الـ experts حقتهم مع بعض، فالـ CPU lane يشتغل تقريبًا بنفس الزيادة. والـ drafter ياخذ 4.25 جيجا VRAM، يعني حوالي 600 expert يطلعون من الكرت. ومحرك Strata يوصل لنفس النتيجة لحاله ويرفض يشغّل DSpark هنا (“its verify rounds read 3.3× a token’s bytes and gain nothing”). الـ drafting يفيد لما الـ experts كلها في الـ VRAM: Strata يقول من 31 لـ 55 إلى 69 توكن/ث على أربع كروت 32 جيجا.
ليش مو 20 توكن بالثانية؟
لكل توكن فيه حوالي 49 ms شغل على الكرت (على 75 واط الكروت تشتغل حول 1 GHz)، وفوقها انتظار الـ CPU lane، لأن فيه حوالي 95 جيجا experts ما تدخل في 32 جيجا VRAM ولا 62 جيجا رام. اللي بيغيّر الرقم: كروت 32 جيجا، أو رام تكفي كل الـ experts، أو حد طاقة أعلى، أو معالج أسرع مع PCIe 4.0. والشي الوحيد الباقي في السوفتوير هو التوجيه اللي يميل للـ cache، وزي ما شفتوا في الجدول، هذا ينقص الجودة.
ملاحظات أمان
- مراقب الحرارة يوقف أي شغل عند 80 درجة. مهمة agent طولها 10 دقايق وصّلت الكرت الثاني لـ 79 درجة على 75 واط، يعني جلسات DeepSeek الطويلة على كروت passive تشتغل على الحافة.
- الهوست طاح مرة وحدة وقت تجربة IQ2_XXS باردة، والحرارة كانت 41 إلى 54 درجة، يعني مو من الحرارة. ما لقيت السبب، ونفس التجربة عدّت بعدين بدون مشكلة.
كيف اشتغلت: أنا و Claude Code
نفس قواعد الجزء الثاني: كل شي داخل Docker، ولا تغيير على الهوست بدون موافقتي، وكل رقم من تشغيل حقيقي فيه لوق. أنا اخترت الأهداف واتخذت القرارات: أي موديلات تنحمّل (وسّعت الديسك عشانها)، وحد الطاقة، وهل نكمل بعد ما طاح الهوست. والـ agent قرأ كود ثلاث محركات، ونقل اثنين منها، وشغّل مقارنات الـ A/B، وتتبّع التعليق لين وصل لنافذة الـ readahead. ولما طاح الهوست ورجعت حدود الطاقة لـ 190 واط، وقف وسألني قبل أي شغل على الكروت.
الكود
- fork من Maya فيه النقل لـ gfx906 وتصليح الـ Engram وخيارات الـ pack:
github.com/0c33/project-maya، فرع
gfx906-deepseek - patch الـ wave64 لـ Strata 0.2.4 وكل السكربتات: في نفس الريبو تحت
docs/mi50/ - الموديلات: ISTA-DASLab GSQ-RCO GGUF، Maya-XS
شكرًا لمطورين Project Maya و Strata و Xolotl على محركات تستاهل النقل، ولـ ISTA-DASLab و Unsloth على الـ quants، ولـ DeepSeek إنهم نشروا الموديل برخصة MIT.