كرتين MI50 (الجزء الثاني): من 10 إلى 74 توكن بالثانية، وكونتكست 200 ألف توكن، وكيرنلين للـ attention
مقدمة
في الجزء الأول تكلمت عن تشغيل كرتين MI50 مع vLLM، وكيف كانت المشكلة في المذربورد مو في السوفتوير. بعد ما اشتغل كل شي، بقى عندي سؤالين:
- ليه DFlash2، أسرع طريقة للـ speculative decoding لموديل Qwen3.8، مكتوب عنه في الـ fork إنه “ميت” على هالكروت؟
- هل أقدر أوصل كونتكست 150 إلى 200 ألف توكن؟ هذا اللي أحتاجه لـ Hermes Agent و opencode، لأن الـ agent يقرأ الكود كامل.
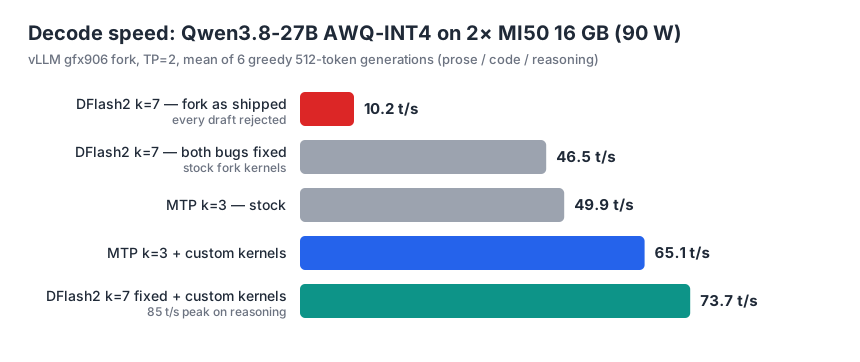
بالمختصر: DFlash2 ما كان ميت، كان فيه مشكلتين تخلّي القبول صفر بالضبط. وصلت لـ 74 توكن بالثانية بدل 10، وصار عندي سيرفر للـ agents بكونتكست 200 ألف توكن على كرتين عمرهم 8 سنين.
وبعدها، بكيرنلين للـ attention وتعديل في الـ prefix cache، صار هالكونتكست الطويل سريع كمان: 48 توكن/ث عند 61 ألف توكن (كان 29)، والدور الجديد للـ agent يبدأ خلال 5 ثواني تقريبًا بدل 12 إلى 14.
الخلاصة بسرعة
| قبل | بعد | |
|---|---|---|
| DFlash2 (k=7) | 10.2 توكن/ث، كل الـ drafts مرفوضة | 73.7 توكن/ث (أعلى شي 85) |
| MTP (k=3) | 49.9 توكن/ث | 65.1 توكن/ث مع الكيرنلات |
| أقصى كونتكست للـ agents | ~96 ألف | 200 ألف (جربته فعليًا على 143 ألف) |
| تواصل الكرتين (all-reduce) | ~72 مايكروثانية | 28 مايكروثانية |
| التوليد عند كونتكست 61 ألف | 29.1 توكن/ث | 48.2 توكن/ث |
| قراءة برومبت 63 ألف من الصفر (prefill) | 90 توكن/ث | 160 توكن/ث |
| دور جديد للـ agent (محادثة 16 ألف توكن) | 12 إلى 14.5 ثانية لأول توكن | 4.4 إلى 5.3 ثانية |
كل هذا والكروت مقيّدة على 90 واط لكل كرت (الافتراضي 190).
كيف اشتغلت: أنا و Claude Code
قبل التفاصيل التقنية، لازم أوضح طريقة الشغل لأنها جزء من القصة. شغّلت Claude Code (Anthropic) كـ agent داخل الـ LXC، وحطيت له قواعد واضحة:
- لا يلمس ROCm حق الهوست أبدًا، وكل شي يصير داخل Docker.
- يستأذن قبل أي تغيير بـ apt على الهوست.
- البيلدات تشتغل في tmux وتنكتب في لوق، لأن الأنوية قليلة.
- أي رقم يطلعه لازم يكون من تشغيل حقيقي، مو تقدير.
أنا حددت الهدف والعتاد والقرارات، وراجعت النتائج. الـ agent سوّى الشغل الثقيل: قراءة كود الـ fork، كتابة الكيرنلات والتصليحات، وتجارب A/B. هذا بالضبط اللي أشتغل عليه كـ AI Engineer، وهنا جربته على مشكلة حقيقية وصعبة.
المشكلة الأولى: fp16 ينفجر
كرت MI50 (gfx906) ما يدعم bf16، فكل شي يشتغل بـ fp16. موديل DFlash2 (الـ drafter) متدرب بـ bf16، وbf16 مداه أكبر بكثير. أكبر رقم يقدر يمثله fp16 هو 65504.
اللي صار إن الـ residual stream داخل الـ drafter يتعدى هالرقم من ثاني طبقة، فيصير inf ثم NaN. الـ drafts تطلع زبالة (التوكنات رقم 0، 1، 2…)، والموديل الكبير يرفضها كلها، فالقبول صفر بالضبط. وهذي مشكلة معروفة في vLLM (#55250).
الحل: كل فرع في الطبقة يقرأ الـ residual stream من خلال RMSNorm، وRMSNorm ما يتأثر لو قسمت المدخل على رقم ثابت. فقسمت الـ stream على 32 (أس من أسس 2، يعني القسمة دقيقة 100% بدون أي خطأ تقريب)، وعدّلت أوزان o_proj وdown_proj مرة وحدة وقت التحميل. المخرجات نفسها بالضبط، والأرقام صارت داخل مدى fp16، وبدون أي تكلفة وقت التشغيل.
المشكلة الثانية: الـ drafter يقرأ ذاكرة محذوفة
بعد التصليح الأول صار DFlash2 يعطي 48 توكن/ث، لكن بس على البرومبتات القصيرة. أول ما يتعدى الكونتكست 2 إلى 4 آلاف توكن، يرجع القبول صفر.
السبب: الـ drafter يستخدم sliding window بحجم 2048 توكن، يعني يشوف آخر 2048 توكن بس. الـ fork أضاف مسار attention “non-causal” للـ drafter، وهالمسار كان يصفّر الـ window، فصار الـ drafter يقرأ الكونتكست كامل. في نفس الوقت، مدير الكاش في vLLM يحذف بلوكات الـ KV اللي طلعت برا الـ window ويعطيها لغيره. يعني الـ drafter كان يقرأ ذاكرة محذوفة.
الحل: صلّحت المسار عشان يحافظ على الـ window باستخدام نفس الماسك الموجود في الكيرنل، والتعديل بايثون بس وبدون إعادة بناء. وكتبت تست يحط NaN في البلوكات اللي برا الـ window، فلو أحد قراها مرة ثانية التست يفشل. التست هذا يفشل على الكود الأصلي وينجح بعد التصليح.
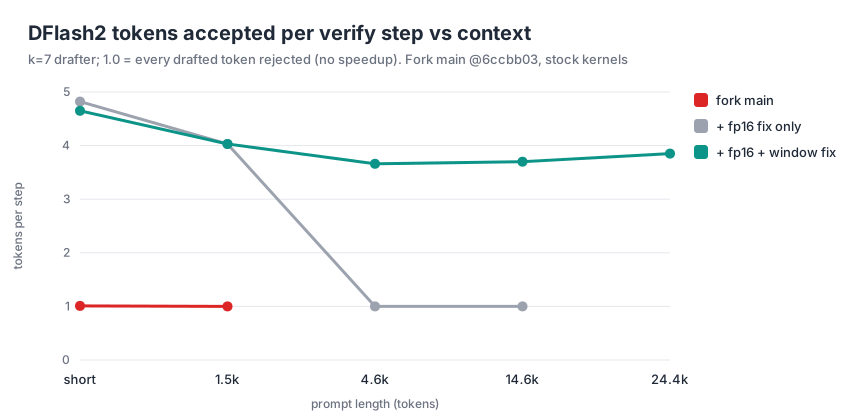
الرسم يوضح الفرق: بالتصليح الأول بس، القبول ينهار بعد 4.6 ألف توكن. بالتصليحين، يثبت على 3.7 إلى 3.9 توكن مقبول في كل خطوة لين 24 ألف توكن.
الكيرنلات: ليش الكود العام بطيء هنا
في الـ speculative decoding، كل خطوة تتحقق من k+1 توكن، يعني عمليات ضرب المصفوفات فيها 8 صفوف أو أقل. هذا الحجم محدود بسرعة الذاكرة مو بالحساب، والمسارات العامة مو مصممة له. فانكتبت ثلاث كيرنلات HIP مخصصة لـ gfx906:
| الكيرنل | وش يسوي | النتيجة |
|---|---|---|
| Skinny fp16 GEMM | ضرب مصفوفات لـ 8 صفوف أو أقل، بقراءات 16 بايت متناسقة وتخزين المدخلات في LDS | lm_head: من 10.3 إلى 3.4 ملي ثانية |
| W4 GEMM | ضرب مع أوزان 4-bit (AWQ)، كل وزن يتفك مرة وحدة لكل الصفوف، والجمع بـ fp32 | أسرع 1.1 إلى 1.7 مرة لكل طبقة، وأدق |
| Host all-reduce | تواصل الكرتين عبر ذاكرة الهوست، لأن ما فيه P2P بينهم | من 72 إلى 28 مايكروثانية، ونفس النتيجة بالبت |
النقطة الأخيرة مهمة: في كل خطوة تحقق فيه حوالي 140 عملية all-reduce. RCCL ياخذ ~72 مايكروثانية لكل وحدة مهما كان حجمها، فالتواصل لحاله كان ياكل وقت كبير. الكيرنل الجديد يكتب كل كرت نصيبه في ذاكرة مشتركة على الهوست، ويستنى علامة من الكرت الثاني، ويجمع. وجربته على 3000 عملية عشوائية: النتيجة مطابقة بالبت لـ RCCL.
كونتكست 200 ألف للـ agents
استخدامي الحقيقي هو Hermes Agent و opencode، والـ agent يحتاج يشوف ملفات كثيرة مع بعض. مع fp16 KV cache أقصى شي وصلته ~96 ألف توكن. جربت ثلاث طرق:
| نوع الـ KV cache | أقصى كونتكست | النتيجة |
|---|---|---|
| fp16 | ~96 ألف | ما يكفي |
| TurboQuant k8v4 | ~220 ألف | ما يشتغل مع MTP k=3، والسرعة نزلت لـ 13 توكن/ث |
| int8 per-token-head | 200 ألف | هذا اللي اعتمدته |
ملاحظة: int8 ما كان يشتغل أصلًا. كان يطيح وقت الإقلاع بسبب مشكلة ثالثة في الـ fork: ملف triton_attn.py يقرأ حقل انحذف من vLLM 0.30. سطر واحد صلّحه.
| طول البرومبت | سرعة التوليد | الدور الثاني (follow-up) |
|---|---|---|
| قصير | 70 توكن/ث | — |
| 63 ألف | 29 إلى 32 توكن/ث | يبدأ بعد ~45 ثانية |
| 143 ألف | 17.6 توكن/ث | يبدأ بعد ~75 ثانية |
جربت على 143 ألف توكن من كود حقيقي، وحطيت معلومة مخفية في أول البرومبت، والموديل تذكرها صح في آخره، وبدون أي OOM. (الإعداد يقلع بـ 200 ألف، لكن أطول برومبت جربته فعليًا هو 143 ألف.)
ليش MTP مو DFlash2 للـ agents؟ لأن DFlash2 ياخذ 1.8 جيجا من كل كرت ولازم الـ prefix caching يكون مقفل، والـ agent بدون prefix caching يعيد قراءة كل شي في كل دور.
اشتغل، بس كان بطيء: أول قراءة لبرومبت 143 ألف أخذت 42 دقيقة، وكل دور للـ agent كان يستنى قريب دقيقة. وهذا اللي صلّحته بعدها.
خلّيت الكونتكست الطويل سريع
كونتكست 200 ألف ما يفيد إذا الموديل ما يقدر يشتغل فيه براحته. فقست وين يروح الوقت، قطعة قطعة. الـ prefill والـ decode كان عندهم نفس المشكلة: الـ attention. كاش int8 اللي خلّى الـ 200 ألف يدخل في الذاكرة، يقراه كيرنل Triton حق vLLM، وهالكيرنل على gfx906 ما يتعدى 1.1 إلى 1.3 TFLOPS. عند برومبت 143 ألف، الـ attention كان تقريبًا 80% من وقت الـ prefill حسب تقديري.
الـ prefill: علّمت كيرنل الـ fork السريع يقرأ كاش int8
على خطوتين:
- بلوكات أكبر. كيرنل Triton كان يشتغل على 16 صف من الـ queries بكل مرة، فكان يعيد تحميل وفك نفس بلوكات الـ keys مرة ورا مرة. بـ 64 صف صار أسرع 1.8 مرة، ونفس النتائج.
- كيرنل أفضل. الـ fork فيه أصلًا كيرنل FlashAttention سريع لـ gfx906 (منقول من llama.cpp ويستخدم تعليمة ضرب int8 حقت الكرت)، بس يشتغل على صيغ الكاش حقته بس. علّمته يقرأ كاش int8 حق vLLM مباشرة: أي حجم بلوك، ومعاملات القياس لكل صف، وبدون أي نسخ. ولما قارنته بمرجع float64 طلعت مشكلتين في الدقة، فصار ضرب المعاملات والتجميع بـ fp32. النتيجة: 4.45 TFLOPS، يعني 3.5 مرة من البداية.
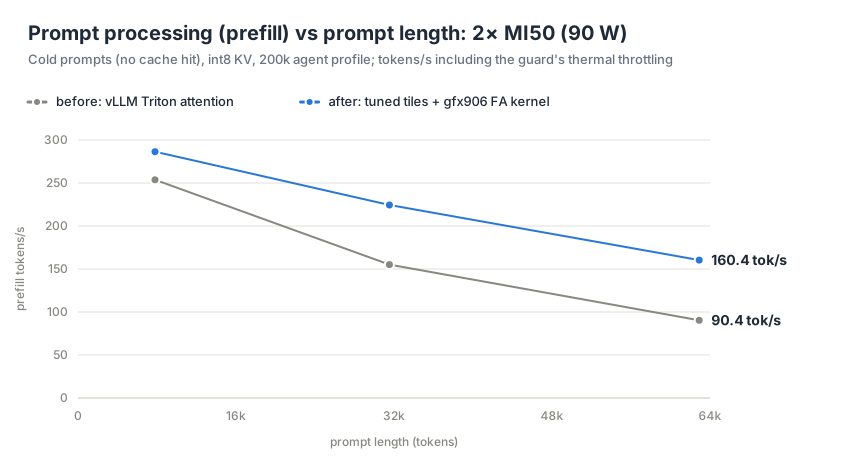
| برومبت من الصفر | قبل | بعد |
|---|---|---|
| 7.8 ألف توكن | 254 توكن/ث | 286 توكن/ث |
| 31.5 ألف توكن | 155 توكن/ث | 224 توكن/ث |
| 62.9 ألف توكن | 90 توكن/ث | 160 توكن/ث |
الـ decode: كيرنل جديد للشكل اللي يشغّله MTP فعليًا
مع MTP، كل خطوة توليد تتحقق من 4 توكنات، وكل 6 heads للـ query يشاركون نفس head للـ KV، يعني 24 صف يقرون نفس الـ keys والـ values. هذا يخلّي الـ attention في التوليد محدود بالحساب، وTriton كان يعطي ~1.1 TFLOPS بس. جربت 39 إعداد مختلف لـ Triton، ولا واحد كان أسرع من الافتراضي.
فكتبت كيرنل decode مخصص لهالشكل بالضبط. كل thread في الـ GPU ياخذ key واحد، يحوّل صفه من int8 لـ fp16 مرة وحدة، ويحسب الـ 24 score كلها بتعليمة ضرب fp16 حقت الكرت. الشغل يتقسم على طول الكونتكست عشان الـ 60 وحدة حساب تبقى مشغولة، والنتائج الجزئية تنجمع بالأخير. ما يحجز أي ذاكرة وما يستنى الـ CPU أبدًا، فيشتغل داخل الـ GPU graphs حقت vLLM. ويغطي خطوة الـ draft حقت MTP بعد.
الكيرنل لحاله أسرع 3.2 إلى 4.5 مرة من مسار Triton. وعلى السيرفر كامل:
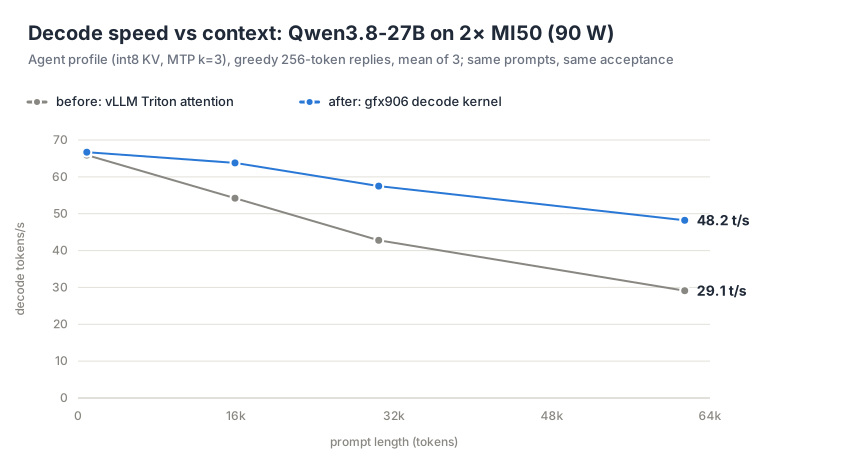
| الكونتكست | قبل | بعد |
|---|---|---|
| 0.9 ألف | 65.9 توكن/ث | 66.7 توكن/ث |
| 15.9 ألف | 54.2 توكن/ث | 63.8 توكن/ث |
| 30.5 ألف | 42.8 توكن/ث | 57.5 توكن/ث |
| 61.4 ألف | 29.1 توكن/ث | 48.2 توكن/ث |
أدوار الـ agent: لا تعيد قراءة شي موجود في الكاش
الـ agent يرسل المحادثة كاملة في كل دور، والمفروض الـ prefix cache يخلّي الجزء الجديد بس هو اللي ياخذ وقت. على هالموديل ما كان كذا. Qwen3.8 يخلط الـ attention مع طبقات Gated DeltaNet، وvLLM يحفظ حالتها بس عند حدود بلوكات الكاش، ومع int8 KV البلوك طوله 1,584 توكن. ومع MTP، vLLM يرمي آخر بلوك متطابق في كل مرة. فكل دور كان يعيد قراءة 2.4 إلى 2.9 ألف توكن شافها قبل.
الحل كان خيارين موجودين أصلًا في vLLM: يطابق البداية كل 16 توكن بدل كل بلوك، ويحفظ نقطة للحالة عند المكان اللي تتفرع فيه الجلسات اللي تشارك نفس البداية. بدون أي تعديل في الكود:
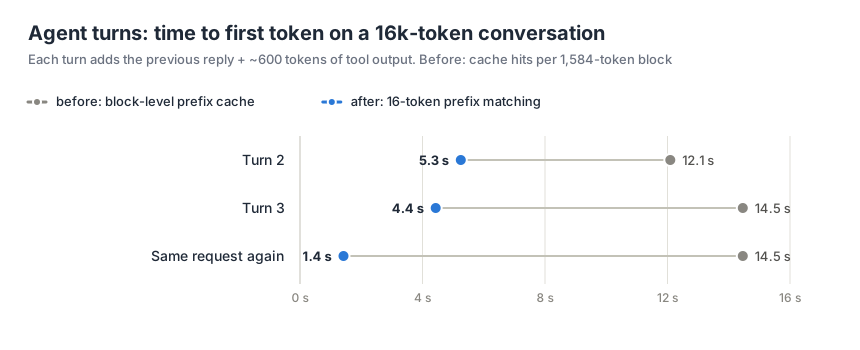
على محادثة 16 ألف توكن، الأدوار تبدأ خلال 4.4 إلى 5.3 ثانية بدل 12 إلى 14.5، والطلب المكرر خلال 1.4 ثانية. وعلى محادثة ~60 ألف، الدور التالي يبدأ خلال 6.2 ثانية (كان ~45). والردود طلعت نفسها بالحرف مع التغيير وبدونه.
هل تغيرت الجودة؟
ما فيه فايدة من كيرنلات أسرع إذا الإجابات تتغير. فالكيرنلين انقارنوا بمرجع float64، وكل تغيير انقارن بالمسار القديم على نفس البرومبتات:
- كيرنل الـ prefill: احتمالات التوكن التالي بعد برومبتات من 4 لـ 34 ألف توكن قريبة جدًا من المسار القديم (KL ≤ 0.0016)، والإجابات نفسها بالضبط.
- كيرنل الـ decode: 192 من 192 توكن نفسها بالضبط عند 3.7 ألف. وعند 16 ألف النصين افترقوا عند التوكن رقم 14، على تعادل تقريبي بين أفضل كلمتين (الفرق 0.047 في الـ log-probability)، وقبلها كل التوكنات نفسها.
- المعلومة المخفية في أول برومبت 59 ألف توكن الموديل تذكرها بعد.
كل الكيرنلات والتستات واللوقات، وسكربت بناء يعيد نفس الصورة اللي أشغّلها، موجودة في الريبو.
المساهمة في المشروع
ما أبي التصليحات تبقى عندي بس. جهزت PR للـ fork (KIntegrated/vllm-gfx906-mobydick) فيه:
- تصليح fp16 وتصليح الـ window، مع تستات (127 تست ناجح)؛
- تجربة A/B على كود الـ fork نفسه: من 10.2 إلى 46.5 توكن/ث بالكيرنلات الأصلية؛
- تحديث التوثيق اللي كان يقول إن DFlash2 “ميت”.
وPR ثاني صغير لمشكلة int8.
- نصوص الـ PR والباتشات الجاهزة لـ
git am: مجلدupstream/في الريبو. - كل الكود والسكربتات والأرقام واللوقات: github.com/0c33/mi50-vllm-lab
وش تعلمت
- “القبول صفر بالضبط” علامة bug، مو ضعف في الموديل. الموديل الضعيف يعطيك قبول منخفض، أما الصفر بالضبط فمعناه إن فيه شي مكسور.
- لا تثق بحكم “ميت” بدون ما تعيد الفحص. كل التجارب اللي قبل كانت تشتغل بـ fp16 المكسور، فكل النتائج كانت غلط من الأساس.
- قِس كل شي بـ A/B. كل تصليح انقاس لحاله، عشان أعرف وش اللي فعلًا فرق.
- العتاد القديم فيه مجال. كرت من 2018 بـ 90 واط يشغّل موديل 27B بـ 74 توكن/ث، لما يكون الكود مكتوب لشكل الشغل الحقيقي.
- قِس قبل ما تحسّن. الـ attention كان المشكلة في الـ prefill والـ decode، بس لأسباب مختلفة، وحل كل واحد جا من القياس مو من التخمين.
- العتاد القديم يبي له عناية. الكروت بتبريد passive وما تتحمل 90 واط لفترة طويلة. كرت وصل حد الحرارة وطفى أثناء تجربة tuning بدون مراقبة، ومن بعدها كل شغل على الـ GPU يمشي تحت watchdog يوقفه عند 80 درجة.
- الـ AI agent مع قواعد واضحة يقدر يشتغل على مشاكل صعبة جدًا، بس لازم أنت تحدد الهدف وتراجع وتتأكد من الأرقام.
الخاتمة
بدأت بسؤال بسيط: ليش DFlash2 ما يشتغل؟ وانتهيت بثلاث مشاكل مصلحة، وخمس كيرنلات (ثنتين منها للـ attention على كاش int8)، وسيرفر أستخدمه كل يوم مع Hermes و opencode بكونتكست 200 ألف توكن على كرتين MI50، وصار سريع كمان.
لو عندك كروت MI50 أو أي gfx906 وتبي تجرب، كل شي موجود في الريبو. ولو عندك سؤال، تواصل معي.